こんにちは!
コアシステムエンジニアリング部門 商品ドメイングループの流川です。普段は商品管理に関わるシステムの開発・保守を担当しています。
※以前公開した記事はこちら:基幹システム運用安定化のアプローチ戦略~困難から見つけた解決の糸口~ - MonotaRO Tech Blog
皆さん、AI使いこなしていますか?昨年11月末から今年の3月末まで育休を取得しており、復帰すると社内にAIムーブメントが到来していてびっくりしました!オフィスのあちこちでAIツールが活用されている光景を目の当たりにし、約4か月ちょっとのお休みの間にすっかり別世界になったような感じで、「乗り遅れるわけにはいかない!」と思った次第です。
※モノタロウのAIの取り組みに関する記事はこちらをご覧ください
そんな私も波に乗るべく、商品データパイプライン構築プロジェクトではプロジェクトマネージャーとしてAIを戦略的に取り入れることで、人に依存しない開発プロセスを確立しつつあります。どうAIを活用して「エンジニアでなくても開発できる環境」を作り上げてきたかをお話しします!
- 1. プロジェクト概要:なぜデータパイプラインが必要だったのか
- 2. 私たちのアプローチ:AIパワードな開発体制
- 3. AI活用事例紹介の前提知識:データパイプラインの基本設計
- 4. エンジニアでなくても開発できる!驚きの開発プロセス
- 5. まとめ:学びと気づき
1. プロジェクト概要:なぜデータパイプラインが必要だったのか
5000億円への道のり
「売上5000億円達成」という大きな目標に向けて、このプロジェクトは誕生しました!
昨年のプロジェクト企画では、商品ドメイングループとしてできることを考え、商品数と売上の関係性についてデータ分析を実施。「5000億円達成には具体的に何点の商品が必要か」という数字を導き出すことができました。データから見えてきたのは、現状モノタロウが取り扱っている商品点数から、かなりの増加が必要だということです。
しかし、業務部門との対話から見えてきたのは、単に商品点数を増やすだけではないという視点。「5000億円達成には総合的なMD(マーチャンダイジング)戦略が不可欠」という認識を共有しました。確かに新規商品採用は重要なKPIですが、価格交渉や納期改善など、MD戦略全体の強化も大切なのです。
そこで私たちは、データパイプラインの構築によって商品採用プロセスを効率化し、MD担当者が本来の戦略的な業務により多くの時間を使える環境づくりを目指すことにしました。このパイプラインは将来的にMD戦略自体の強化ツールとしても活用できるはず。
まさに私たちのプロジェクトは、5000億円への道のりを支える重要な基盤づくりなのです!
現行プロセスの課題
商品採用プロセスには、複数の課題が存在しています。
第一に「処理ツールの限界」があります。現在使用しているVBAツールは数百項目ものクレンジングを要し、大量データの処理に適していません。業務量が増えるにつれて、このツールがボトルネックになっています。
第二に「サプライヤ側の負担」の問題があります。現状ではサプライヤに当社指定の特定フォーマットでの情報提供を求めており、これが当社への商品提案の障壁となっている可能性があります。各サプライヤ、それぞれが持つ商品情報をより柔軟に受け入れる環境の整備が必要です。
第三に「データ処理の標準化不足」が挙げられます。Webフォームやメール添付のExcelなど、多様な形式で受け取るデータに対して標準的な処理方法が確立されておらず、業務担当者の工夫と努力で対応している状況です。
これらの制約と「人依存」のプロセスでは、商品採用量の大幅な拡大は困難です。サプライヤと当社双方にとって、より効率的で柔軟性の高いプロセスを構築することが本プロジェクトの主要目標です。このボトルネックを解消するために、データパイプラインの構築に着手しました。
2. 私たちのアプローチ:AIパワードな開発体制
チームの多様性が強み
このプロジェクト、実はすごいんです!テック部門と業務部門が協働で開発を進めています。技術的な知識を持つITエンジニアと商品データの専門知識を持つ業務担当者が一緒になって開発しているんです。
そんな多様なチームで開発を爆速で進めるための秘密兵器が「AI活用」です!
3. AI活用事例紹介の前提知識:データパイプラインの基本設計
これからご紹介するAI活用事例を理解するために、まずはデータパイプラインの基本的な仕組みを簡単に説明します。ここで説明する設計が、後述するAI活用の土台となっています!
シンプルだけどパワフルなアーキテクチャ
私たちが構築しているデータパイプラインは、GCPのDataformを核としたシンプルな仕組みです。設計思想として「シンプルであること」と「テック部門に頼らず業務部門だけでも改善できること」、そして「無理なくスケールできること」を大事にしています。
特にスケーラビリティを重視しました!処理データが大幅に増えても、ボトルネックにならないよう、クラウドのマネージドサービスを活用してオートスケールする設計にしています。この仕組みなら、業務フローが複雑化したり、データソースが増えたりしても、システム側はほぼ自動的に対応してくれるんです。
プログラミングの専門知識がなくても、SQLの基本さえ分かれば業務担当者自身が改善できるよう、ビジネスロジックはすべてSQLベースのプラットフォームで定義しています。モノタロウでは業務部門の方々もSQLを活用できるスキルを持っているため、この設計はとても親和性が高く、データチェックルールの追加や変更のハードルを大幅に下げることができました。
また、将来的にはWebフォームだけでなく、例えば大手サプライヤとの商品情報API連携など、データ登録フローが増える可能性も見越しています。どんな形でデータが入ってきても柔軟に対応できるよう、拡張性の高いデータモデリングを行っているんです!
マルチホップアーキテクチャによるデータパイプライン
データパイプラインの核心は「マルチホップアーキテクチャ」と呼ばれる設計パターンです。これは単なるデータの流れ方を定義しているのではなく、システム全体の柔軟性と拡張性を高めるための考え方を適用しています。データが以下の5つのホップ(レイヤー)を段階的に通過していきます:
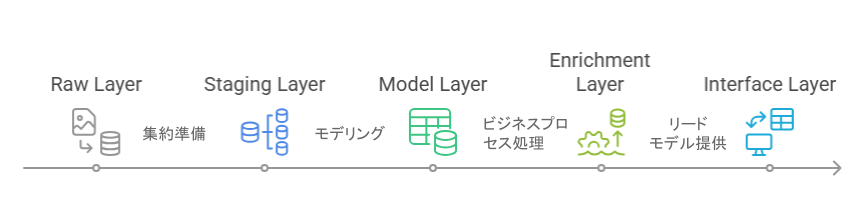
1. Raw Layer(第1ホップ):サプライヤから受け取ったデータを加工せず原形のまま保存します。これは「単一源泉」として機能し、後続処理でどんな問題が発生しても、常に元データに立ち返ることができます。
2. Staging Layer(第2ホップ):後続レイヤー処理のための準備を行います。ここでは、商品情報を一意に特定するためのキー採番やデータソース固有のデータクレンジングを実施します。
3. Model Layer(第3ホップ):ビジネスの中核となる「標準データモデル」を構築するレイヤーです。異なる形式の入力データをここで統一された正規化モデルに変換します。各コンテキストに応じて商品基本情報、属性情報、商品該当法令情報等のエンティティに分割し、関係性を明確にしたモデリングを行います。データソースによらず、データ構造はここで一元化され、後続処理は入力元を意識する必要がなくなります!
4. Enrichment Layer(第4ホップ):ビジネスデータ自体ではなくモデル化されたビジネスデータに対するビジネスプロセスのステータス遷移状態を管理します。例えば、バリデーション結果(OK/NG)やビジネスステータス(採用判断中/採用判断/不採用、売価試算中/売価試算完了)等の各業務ステータスを商品ごとに記録することで、商品採用プロセスを完全デジタル化し、各ステップにかかる時間を計測。これによりボトルネックを特定できるようにし、商品採用プロセスの継続的改善を実現します。
5. Interface Layer(第5ホップ):「リードモデル」として機能し、外部システムとの連携用インターフェースを提供します。基幹システム向け、分析システム向けなど、各システムに最適化されたデータ形式に変換します。このレイヤーは各システム専用の「翻訳者」として、モデルレイヤーのデータを目的別に加工・提供します。
疎結合化の威力
このアーキテクチャの最大の強みは「疎結合化」です!各レイヤーは明確に分離され、それぞれが独自の責務を持ちます。これにより以下のような利点が生まれます。
- 入力側の独立性: 新しいデータソース(例:APIからの商品データ連携)が追加されても、Raw/Staging層だけの変更で済みます。Modelレイヤー以降は変更不要なため、ビジネスロジックに影響を与えません!
- 出力側の独立性: 新しい連携先システムが増えても、Interfaceレイヤーを追加するだけで対応可能。既存のデータモデルやビジネスロジックを変更する必要がありません。
- 進化の柔軟性: 各レイヤーが独立しているため、例えばビジネスロジックだけを改善したり、データモデルだけを再設計したりといった部分的な進化が可能です!
- チーム間の並行開発: テック部門はデータパイプラインの基盤部分を、業務部門はビジネスロジックやチェックルールを、それぞれ独立して開発・改善できます。
この疎結合アーキテクチャにより、データの受け取り方が変わっても、連携先システムの仕様が変わっても、システム全体への影響を最小限に抑えることができます。まさに「変化に強い」データパイプラインといえます!
トレーサビリティの確保とデータリネージの活用
マルチホップアーキテクチャの採用により、データの流れは複雑化し、多くの変換や処理が各レイヤーで行われます。そのため、データの追跡性(トレーサビリティ)の確保が不可欠になります。私たちはこの課題に対して、Dataformの強力なデータリネージ機能を活用しています。
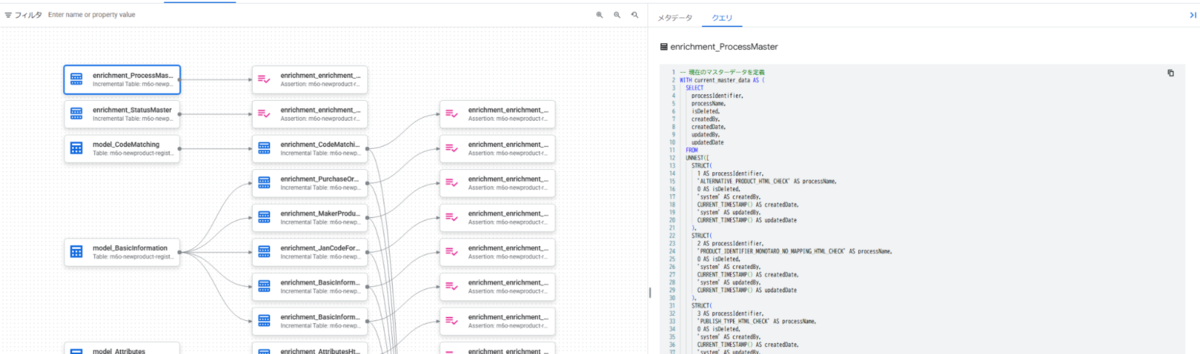
データリネージとは、データの起源から最終的な出力までの変換経路を視覚的に追跡できる機能です。Dataformでは、SQLクエリ間の依存関係を自動的に分析し、データがどのように変換され、どのテーブルに影響を与えるかをグラフ形式で表示してくれます。
これにより得られる主なメリットは以下の通りです:
- 影響範囲の把握: あるテーブルやカラムを変更した場合、その変更がパイプライン全体のどの部分に影響するかを視覚的に確認できます。「この商品属性の定義を変えたら、どの下流プロセスに影響するか?」といった疑問に対して、データリネージの可視化により影響関係を追跡することができます!
- 問題の迅速な特定: データ品質の問題が発生した場合、その原因がどのレイヤーのどの処理にあるのかを素早く特定できます。例えば「なぜこの商品のカテゴリ情報が正しくないのか?」という問いに対して、データの流れを逆にたどることで問題の根本原因を発見できます。
- ドキュメントの自動化: システムの変更が頻繁に行われる環境では、ドキュメントの手動更新は現実的ではありません。データリネージは「生きたドキュメント」として機能し、常に最新のデータフローを可視化します。
具体的な例を挙げると、商品採用プロセスの改善のために新しいチェックルールを追加する際、そのルールが既存のどのデータに影響するかを事前に把握できるため、変更の影響範囲を正確に評価することができます。また、サプライヤからのデータ連携フォーマットが変更された場合でも、どのSQLクエリを修正すべきかを視覚的に確認できるため、改修作業が格段に効率化されます。
このように、Dataformのデータリネージ機能を活用することで、複雑なマルチホップアーキテクチャにおいても高いトレーサビリティを維持し、安全かつ迅速な改修を実現しています!
[例:データパイプラインの処理抜粋。処理間の依存関係と処理内容が視覚化される]
4. エンジニアでなくても開発できる!驚きの開発プロセス
変わる開発スタイル:AI駆動開発の実践
私たちのプロジェクトでは、AIを開発の中心に据えた「AI駆動開発」を実践しています。
「コーディングできないとデータ処理システムは開発できない」は、もう過去の話。このプロジェクトでは、業務担当者でもビジネスロジックを実装できるようになっています!
そしてなんと!ロジックを自然言語で説明すれば、AIがコードに変換してくれちゃうんです💡
開発とユニットテスト:Clineパワー全開!
Clineとは、VS Codeの拡張機能として動作するAIコーディングアシスタントです。OpenAI、Anthropic、Google Geminiなど様々なAIモデルを選択して利用できる強力なツールで、コード生成からリファクタリングまで幅広く対応してくれます。
私たちはClineを使った開発プロセスを確立しました。誰でも同じように質の高いコードを生成できるよう、開発標準を準備しています。
開発者はまず、この開発標準をClineに読み込ませます。次に「商品名に禁止文字が含まれていないかチェックしたい」などのビジネスチェック要件を伝えると...驚くべきことに、プロダクトコードとテストコードの両方を自動生成してくれるんです!
AI駆動開発の第一歩は開発手順のテンプレート化だと実感しています。テストコードについても自動生成できるよう、ユニットテストの仕組み等のCI/CDを事前に準備しておくことがポイントです。(これは開発プロセスを確立するうえでAIにかかわらず重要ですね!実はAIの前にしっかりとした開発基盤を作っておくことで、AIの真価が発揮されるんです)
開発ルールやノウハウが詰まった「開発標準」はGitHubで一元管理し、誰でも閲覧・活用できるようにしています。新しいチェックパターンやコーディングのコツを発見したら、すぐにこの標準に追加できる仕組みにしました。例えば「この正規表現パターンを使うと禁止文字チェックが効率的」といった発見をしたら、Clineに「このパターンを開発標準に追加して」と指示するだけで反映されます。こうして知識が個人に閉じず、チーム全体の財産になる好循環を生み出しています。
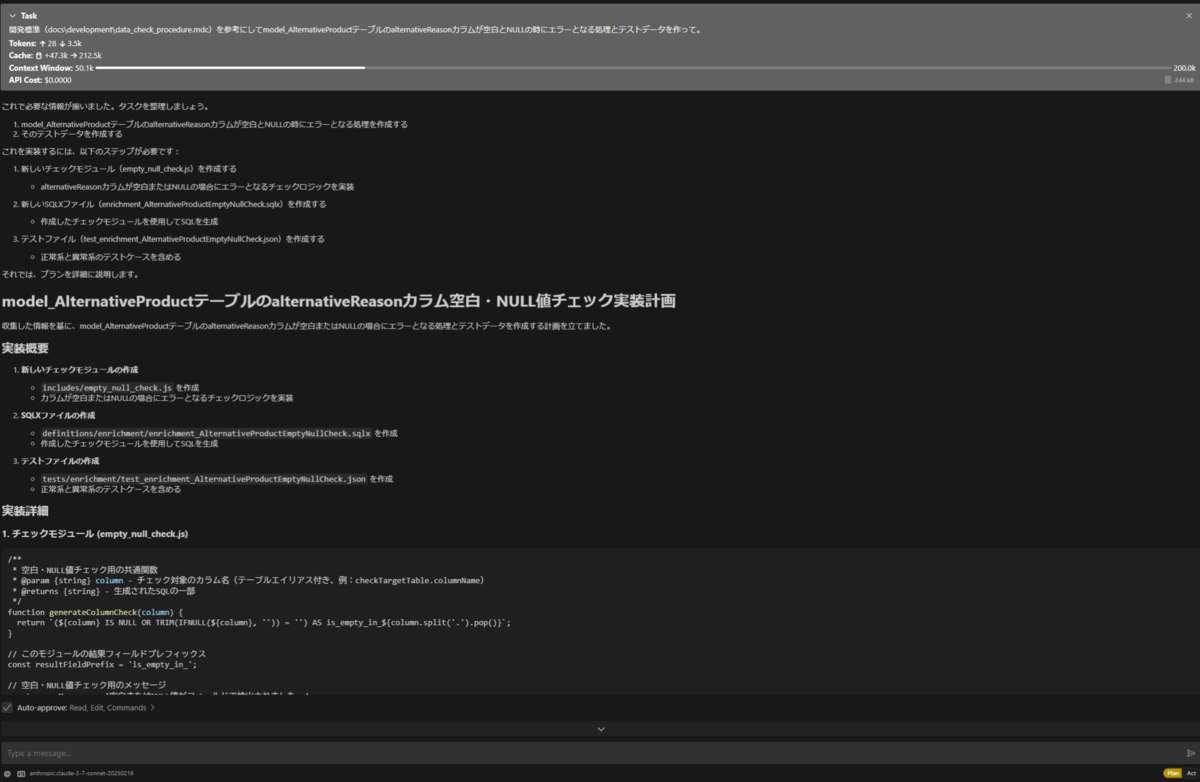
[開発イメージ]
開発者がプロンプトを入力すると、AIが実装計画を立て実行していく。
(例)「開発標準(docs\development\data_check_procedure.mdc)を参考にしてmodel_AlternativeProductテーブルのalternativeReasonカラムが空白とNULLの時にエラーとなる処理とテストデータを作って。」
[AIによる成果物例]
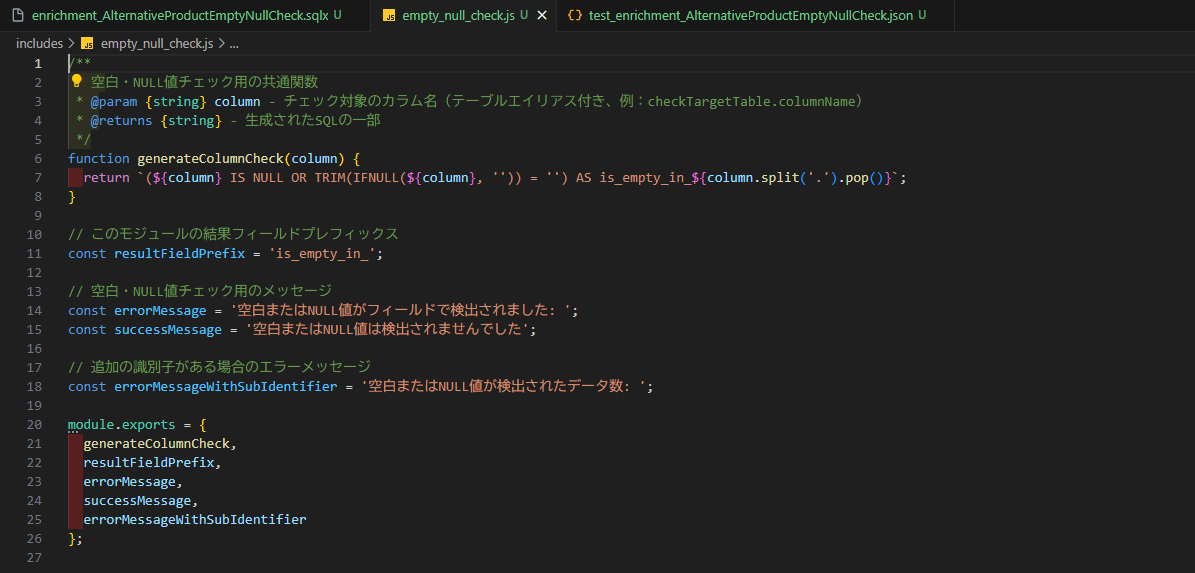
稼働するプロダクトコードの提示
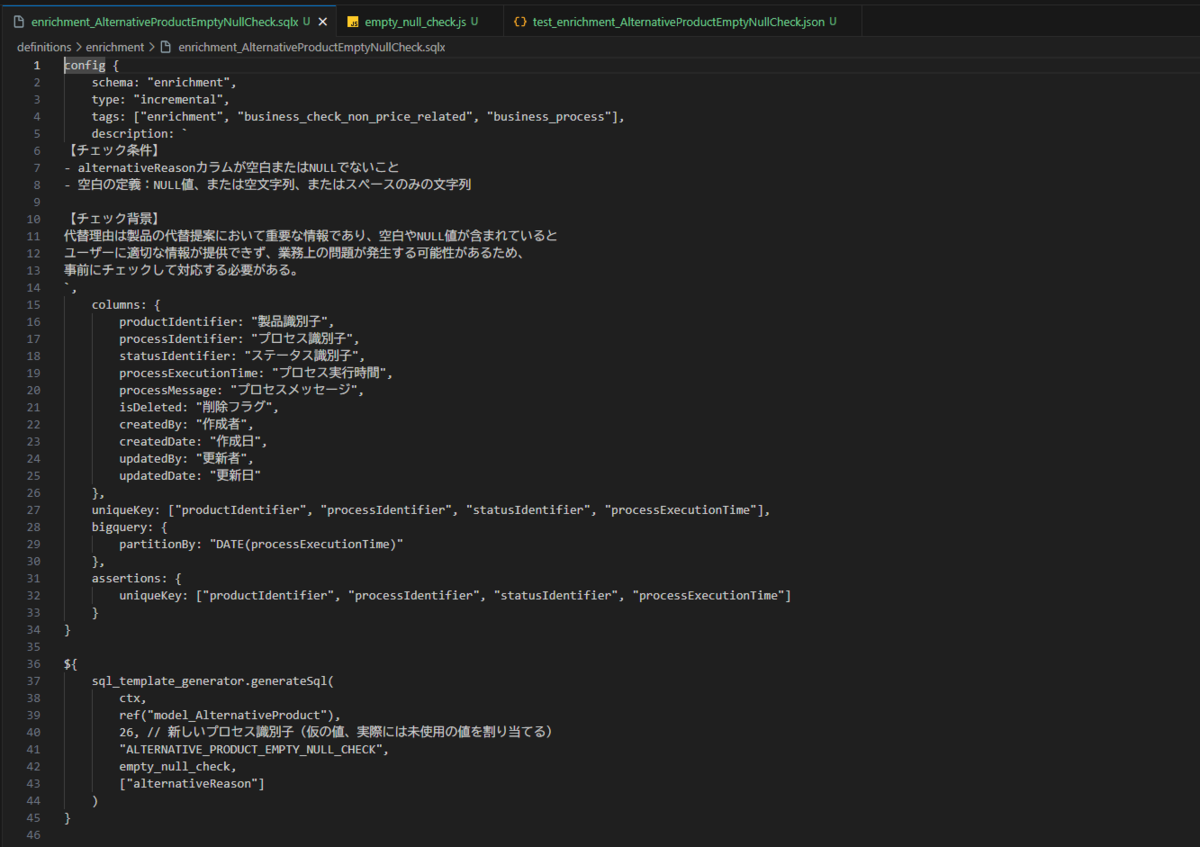
開発標準ではビジネスロジックをライブラリ化して再利用可能にするように指示があることを踏まえて、要件を満たす処理を共通メソッドとして提示
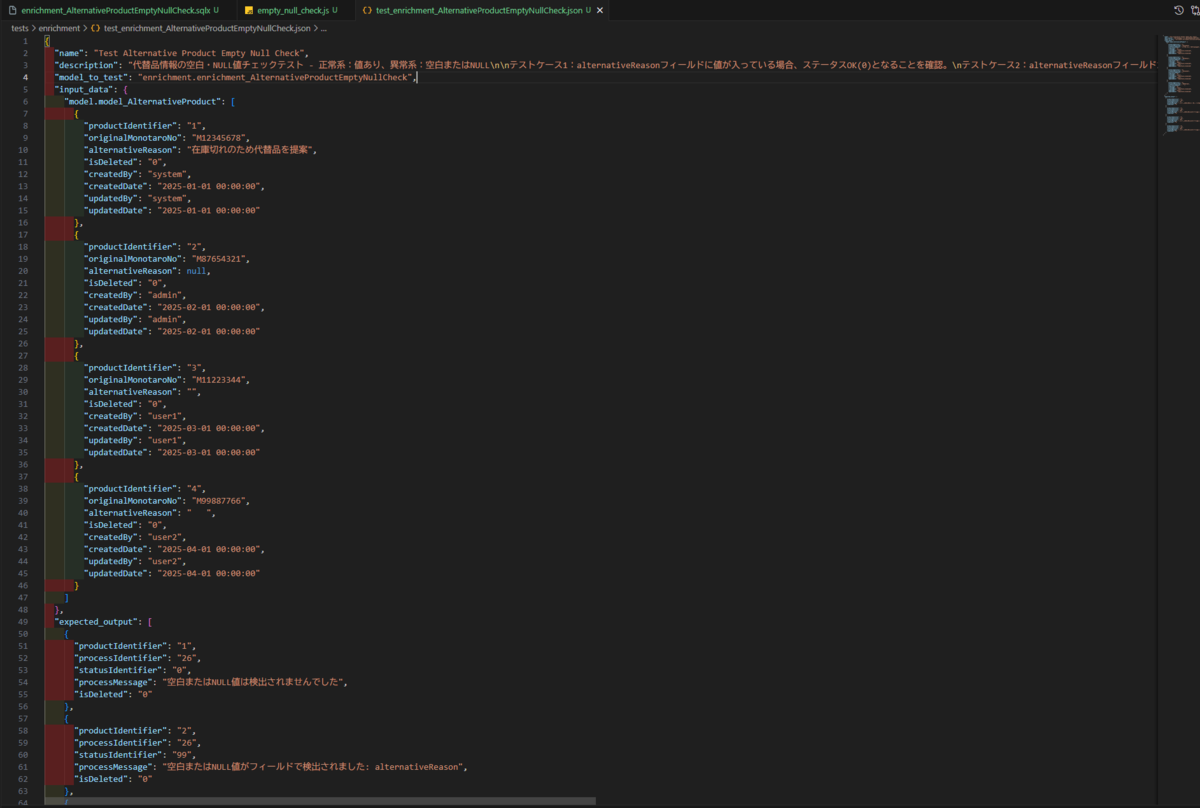
作成した要件の分岐網羅を確認するためのユニットテストデータの提示。 ※ユニットテストではテスト実行時のこのデータを処理の参照テーブルにモック注入し、処理実行後に期待結果であることを確認することで品質確保する仕様
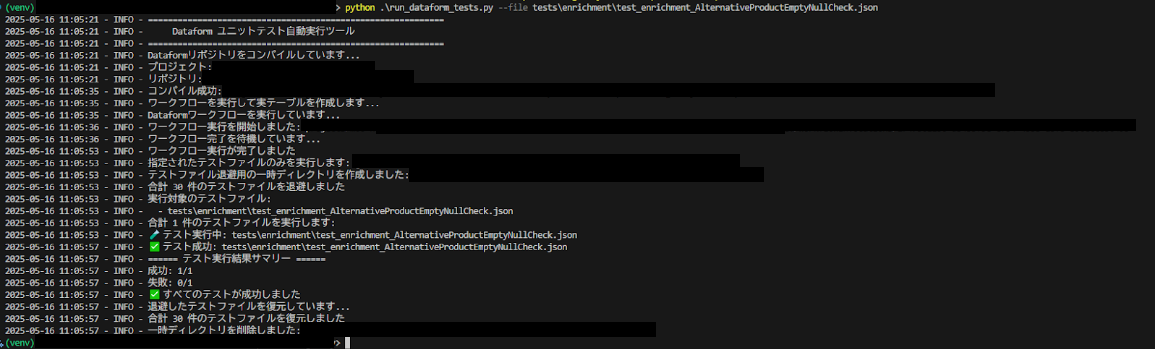
ユニットテストの実行結果。プロンプトの指示の仕方や開発標準の整備方法によってユニットテストの自動実行やプルリクエストの自動作成までしてくれます。
レビューもAIにお任せ:賢いレビュー機能
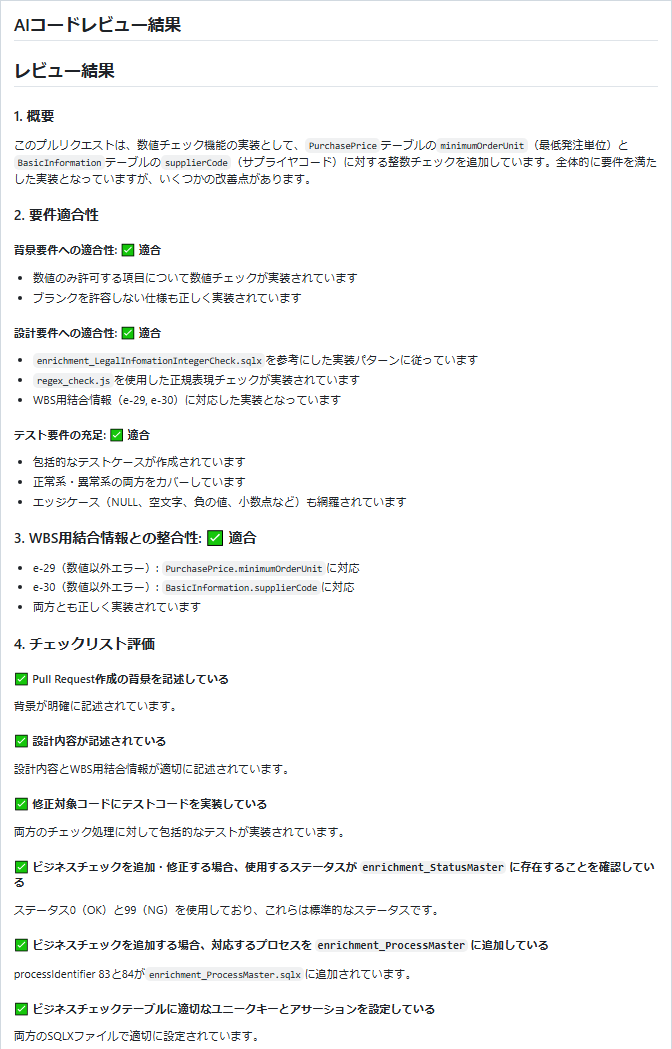
コードレビューでも革新的な取り組みを行っています。プルリクエストに対して自動的にAIレビューを行う機能を構築し、GitHub Actionsに組み込みました!
[プルリクエストに出力されたAIコードレビュー結果サンプル]
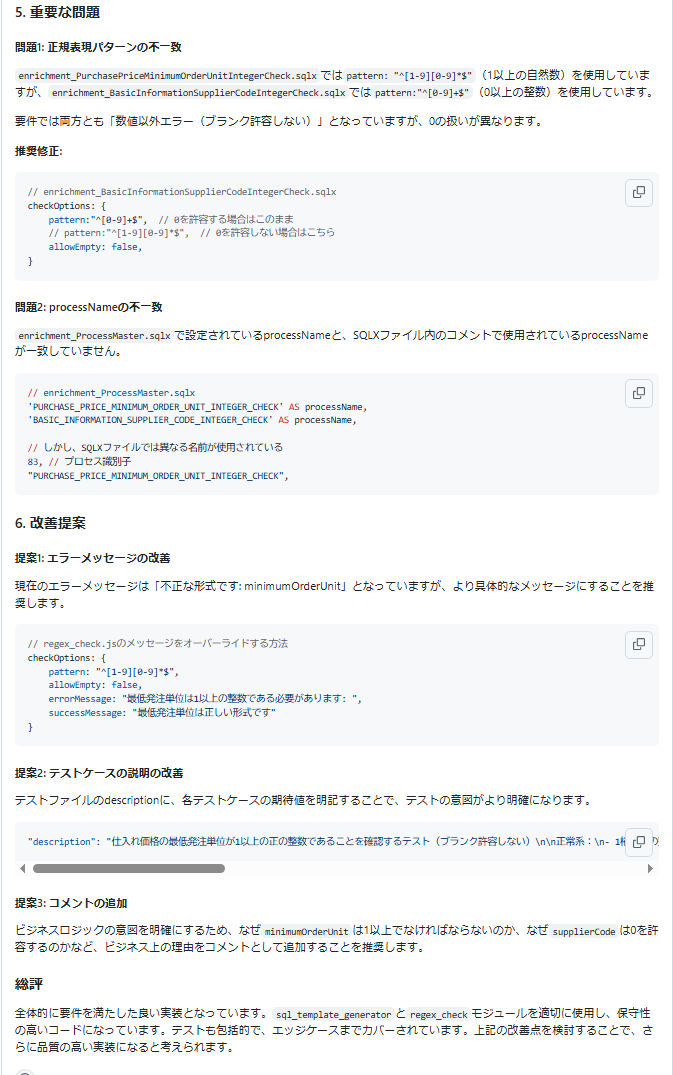
AIレビューの仕組み: 情報収集とプロンプト構築
AIレビューシステムは下記のPython処理を準備し、Github Actionsに組み込んでいます。
GitHub APIを使って、プルリクエストの情報を自動収集
- プルリクエストのコード変更(diff)
- タイトルと説明文
- 開発標準などのレビュー時参照ファイル
テンプレートベースのプロンプト生成
収集した情報を、あらかじめ用意したテンプレートに当てはめます。このテンプレートには変数プレースホルダーが埋め込まれており、実行時に実際の値に置き換わります。
PROMPT_TEMPLATE = """
あなたは経験豊富なDataformエキスパートとして、以下のコード変更のレビューを行ってください。

# プルリクエスト情報
タイトル: {pr_title}
説明: {pr_description}

# 変更内容
{diff}

# レビュー時参照ファイル
{reference_files}

## レビュー観点
1. 要件への適合性
2. SQL構文の正確性
3. パフォーマンスへの配慮
...
"""
AIによるレビュー実行
完成したプロンプトをClaude AIに送信し、レビュー結果を取得します。
知識の蓄積と継続的進化
システムがより賢くなるポイントは、「参照ファイル」の仕組みにあります。設定ファイルで指定した各種ドキュメントが自動的にAIに読み込まれ、レビュー時の判断材料となります。
参照ファイル設定の例
REFERENCE_FILES = {
    ".github/PULL_REQUEST_TEMPLATE.md": "プルリクエストテンプレート。レビュー観点が記載。",
    "docs/development/data_check_procedure.mdc": "データチェック機能の開発手順。",
    "docs/process_requirements/data_validation_rules.csv": "データ検証要件一覧。"
}
「AIがプロジェクトと一緒に成長する」というのがポイントです!具体的には、設定ファイルでレビューの際には「開発標準.md、TIPS集.md、データモデル定義書.xlsx」などを参照するよう指定できます。プロジェクトで得た新しい知見(「NULLとEMPTYの扱いに注意が必要」など)はこれらの資料に随時追記していきます。AIレビューが実行されるたび、最新の開発標準やTIPSが自動的に読み込まれるので、チームの成長がそのままAIの賢さに反映されるんです!
例えば昨日のレビューで「このパターンだとバグが起きやすい」という発見があれば、すぐにTIPS集や開発標準に追記。翌日からのAIレビューでは、そのTIPSを踏まえたアドバイスが自動的に提供されます。まさに「蓄積した知見をAIが再利用する仕組み」です。
これにより、一般的な技術観点のレビューだけでなく、モノタロウやプロジェクト固有の関心事項を踏まえたレビュー結果を自動取得できるようになりました。この仕組みをGitHub Actionsに組み込むことで、一次レビューを人からAIに代替。効率アップに大きく貢献しています!
プロジェクトでのその他AI活用事例紹介
知見循環システム:プルリクエストからTipsを自動生成
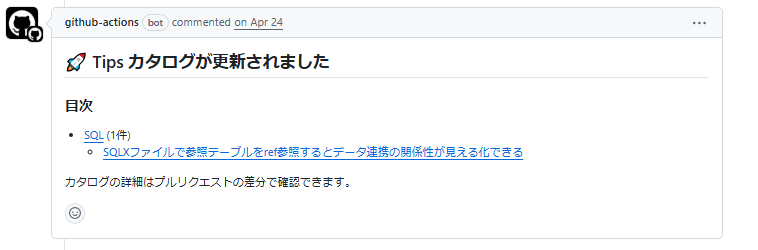
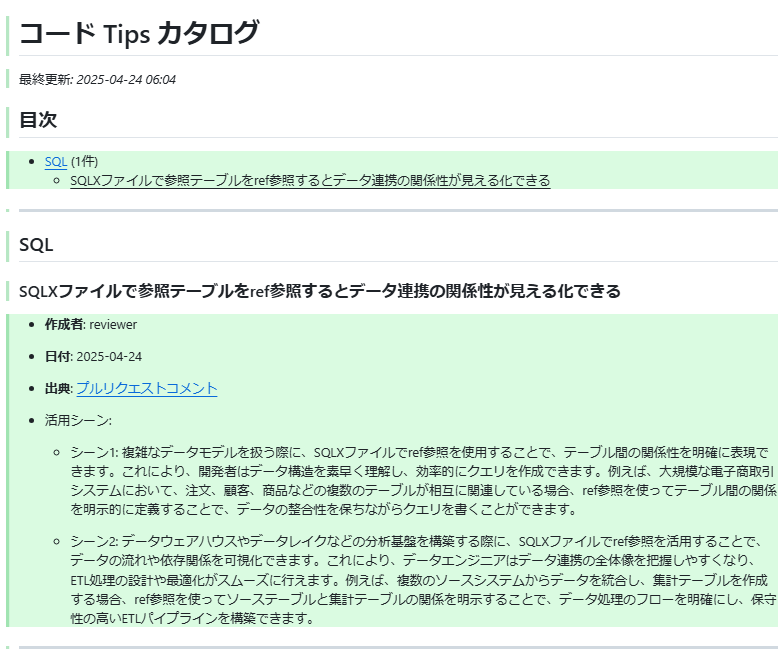
プルリクエストコメントに特定キーワードを入力すると、プルリクエストのコメントとレビュー対象コードの内容をAIが解釈し、Tipsカタログを自動更新するシステムもプロトタイプとして開発しました。これにより、「レビュー → 知見の発見 → Tipsへの自動追加 → 次回AIレビューで活用」という知識循環サイクルが生まれます。チームのノウハウが自然と蓄積され、それが自動的にAIレビューの質向上につながるので、個人の気づきがチーム全体の財産になっていくんです!
要件からの自動コード生成
現在は、要件定義/設計の成果物そのものをClineが理解しやすい形に変換し、Gitで管理しています。これにより細かな要件の指示さえ不要になり、レビュー時もAIレビューにこの成果物を参照させることで要件を満たす実装になっているかを自動判断できるようにしています。ただし、参照ファイルが多くなりすぎるとAIの解釈の質が落ちることがあるのでバランスを見る必要があることが分かっています。
パフォーマンス分析の自動化とAIインサイト
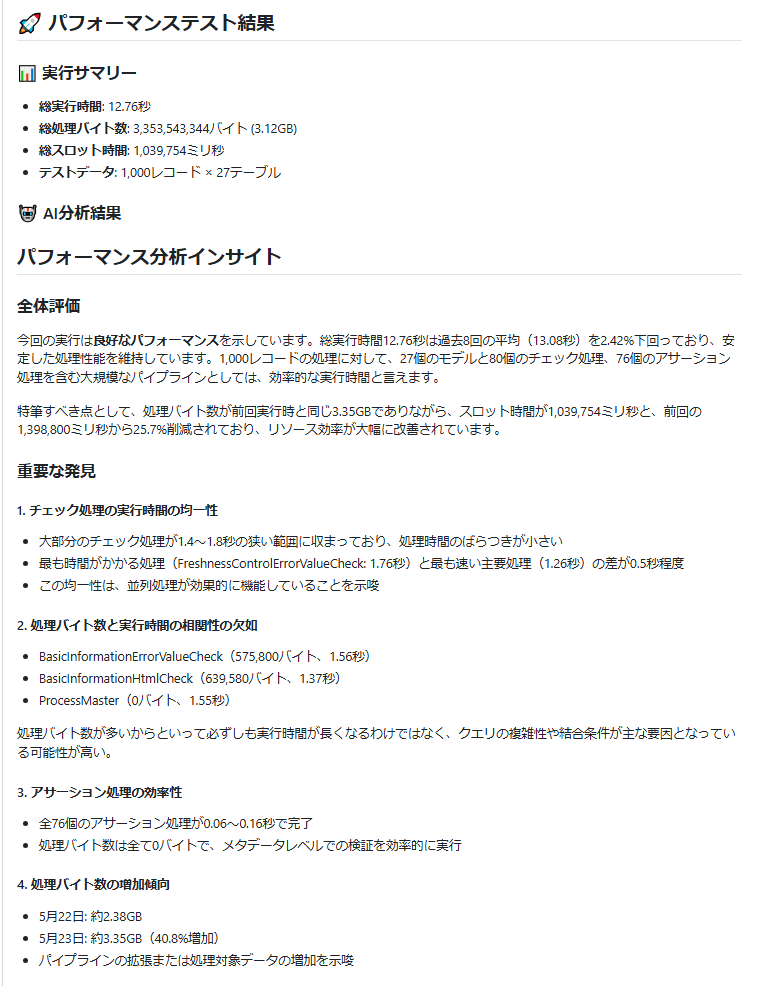
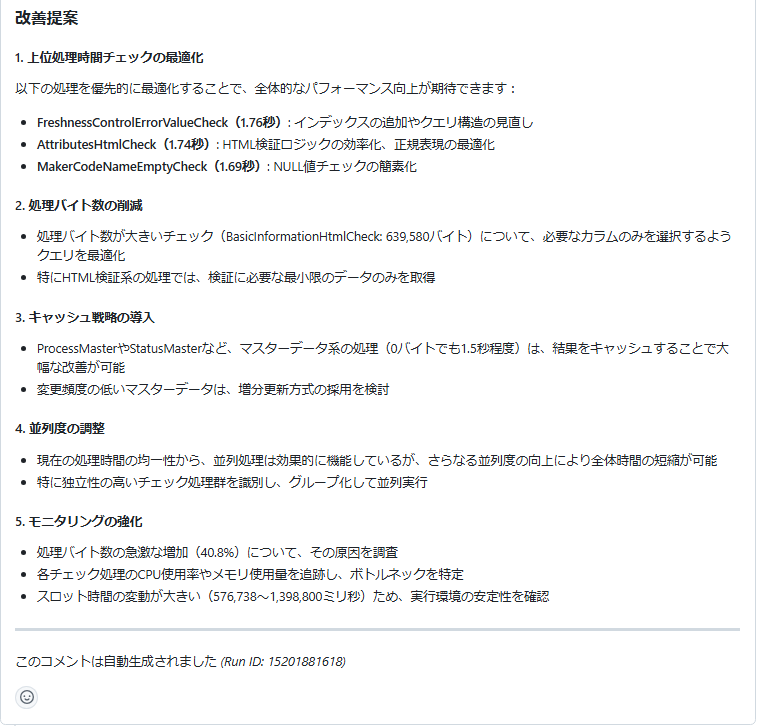
パフォーマンス分析のためのGitHub Actionsも開発しました!このアクションでは、実行時に負荷をかけたいレコード数を指定するだけで、パイプラインのテーブル構成を自動解釈し、指定数のテストデータを自動生成・ロードしてパイプライン処理を実行します。処理結果はデータベースに履歴として保存され、AIがこれらの履歴データを分析して「このビジネスロジックがボトルネックになっている」といったパフォーマンスのインサイトを自動的に提供してくれるんです。これにより、データ量が増えた際のボトルネックを事前に特定し、対策を講じることができます。
5. まとめ:学びと気づき
AIの威力とこれからの開発スタイル
このプロジェクトを通じて、AIの威力を肌で感じました!プロジェクトを推し進める傍ら、復職後の約ひと月で開発プロセスを確立できたのは、実装ハードルの大半をAIが担ってくれたおかげです。技術調査や不足知識をAIのアウトプットをたたき台にして高速で改善できる体験は、本当に素晴らしいものでした。
現在はとても良いサイクルが回り始めており、プロジェクト完遂に向けてさらなる効率化を進めています。
AIと人間の協働は、これからの開発スタイルの「当たり前」になるかもしれません。このプロジェクトの経験がみなさんのお役に立てれば幸いです。なお、本記事で紹介した内容は、モノタロウ社内イベント「AI駆動開発トレンドラボ」でも共有する予定です。社内でもAI活用の知見を広げていきたいと考えています。
【おまけ】実はこのブログ記事も「AIとの協働」の産物です!プロジェクトの設計書やドキュメントをAIに読み込ませ、私の考えを伝えながら一緒に作成しました。記事の構成から表現の微調整まで、AIの力を借りることで短時間で読みやすい記事に仕上げることができました。まさに「言うは易く行うは難し」ではなく、「言えば、AIがやってくれる」時代の到来ですね!
モノタロウでは随時エンジニアの採用募集をしております。この記事に興味を持っていただけた方や、モノタロウのエンジニアと話してみたい!という方はカジュアル面談 登録フォームからご応募お待ちしております。
